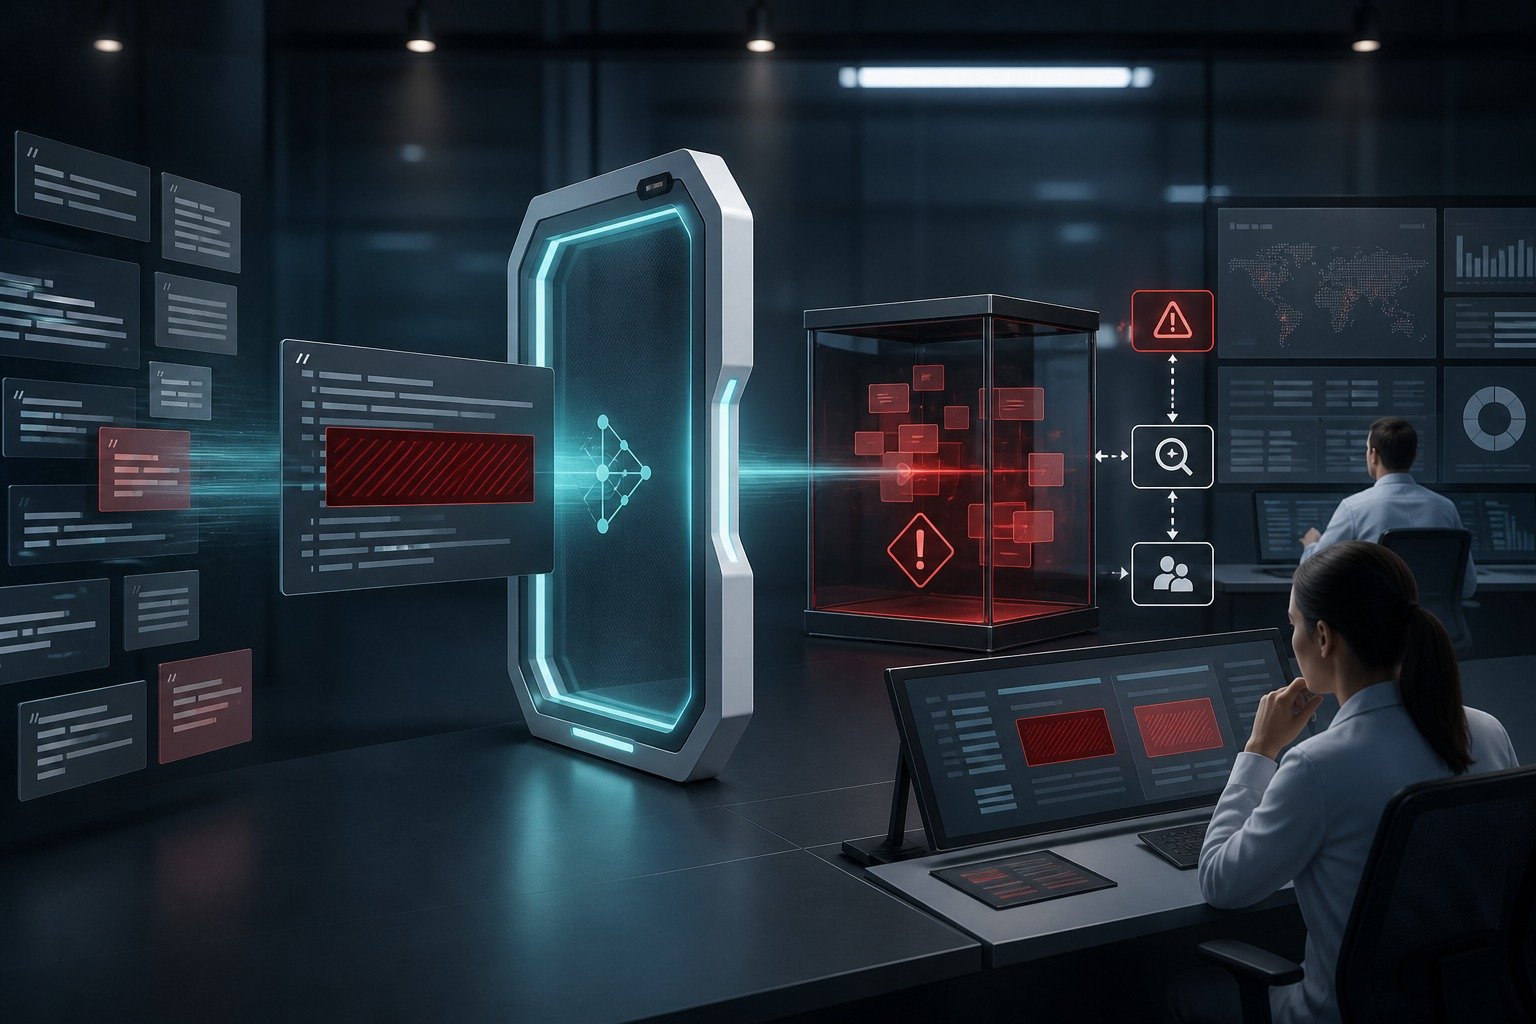
Una nuova tecnica di evasione attribuita al gruppo UAC-0099 mostra come gli attaccanti stiano sperimentando modi per interferire con gli scanner di sicurezza basati su intelligenza artificiale. Il metodo, indicato come GuardBreaker, consiste nell'inserire nei commenti del codice malevolo istruzioni pensate per attivare i meccanismi di sicurezza dei modelli linguistici usati nell'analisi automatizzata.
Come cambia l'evasione degli scanner
Gli strumenti di malware analysis integrano sempre piu spesso modelli AI per riassumere script, individuare comportamenti sospetti o assistere gli analisti nella classificazione. GuardBreaker sfrutta proprio questa integrazione: non tenta di nascondere solo il codice a motori tradizionali, ma prova a condizionare il livello interpretativo del modello che legge il contenuto.
Secondo le ricostruzioni disponibili, l'attaccante inserisce una frase nei commenti del codice con l'obiettivo di provocare un rifiuto o un blocco da parte del modello, inducendolo a non completare l'analisi. La tecnica non elimina la necessita di controlli statici e dinamici tradizionali, ma evidenzia un punto debole dei flussi che affidano a un modello linguistico una parte del giudizio tecnico.
Prompt injection contro la sicurezza
Il caso rientra nella famiglia piu ampia delle prompt injection: input apparentemente passivi vengono scritti per alterare il comportamento di un sistema AI. In ambito cybersecurity questo e particolarmente rilevante, perche i modelli possono leggere file, log, email, ticket o codice provenienti da fonti non fidate.
Per i team difensivi, la lezione e chiara: ogni contenuto analizzato da un modello deve essere trattato come input ostile. I sistemi AI impiegati nella sicurezza devono separare istruzioni operative e dati da analizzare, applicare policy robuste, conservare evidenze verificabili e non diventare l'unico criterio per decidere se un campione sia benigno o malevolo.
Implicazioni per SOC e sviluppatori
Le organizzazioni che usano assistenti AI per analizzare codice sospetto dovrebbero introdurre controlli di coerenza tra output del modello, risultati degli scanner tradizionali e revisione umana. Un rifiuto generico o una risposta incompleta non dovrebbe mai essere interpretato come assenza di rischio.
GuardBreaker conferma che l'adozione dell'AI nei processi di sicurezza richiede threat modeling specifico. I modelli possono aiutare gli analisti, ma devono operare dentro architetture che prevedono input non fidati, logging, isolamento e procedure di fallback quando l'AI non produce una valutazione affidabile.